Koristite zastareli preglednik. Možda se neće pravilno prikazivati ova ili druge veb stranice.
Trebalo bi da nadogradite ili koristite alternativni preglednik.
Trebalo bi da nadogradite ili koristite alternativni preglednik.
Lokalno korišćenje AI modela
- Začetnik teme Space Beer
- Datum pokretanja
GEMMA je ipak puno brži LLM od QWEN... Trebalo bi da je i bolje optimizovana za agentic rad, tako da ko eksperimentiše sa Openclaw, trebalo da je puno bolji izbor od QWEN-a. Ipak, imati u vidu da za neke generalne upotrebe nije baš dobra kao QWEN, jer prompt barata sa 4b od 26b parametara. Iako je preko MCP-a povezana na web search, ipak vadi odgovore iz svog "znanja" i to nije baš najsvežije. Čak i eksplicitan prompt da koristi search i rezultate od zadnjih 7 dana ne pomaže previše.
Kod:
ggml_metal_device_init: GPU name:   MTL0 (Apple M5 Max)
ggml_metal_device_init: GPU family: MTLGPUFamilyApple10  (1010)
ggml_metal_device_init: GPU family: MTLGPUFamilyCommon3 (3003)
ggml_metal_device_init: GPU family: MTLGPUFamilyMetal4  (5002)
ggml_metal_device_init: simdgroup reduction   = true
ggml_metal_device_init: simdgroup matrix mul. = true
ggml_metal_device_init: has unified memory    = true
ggml_metal_device_init: has bfloat            = true
ggml_metal_device_init: has tensor            = true
ggml_metal_device_init: use residency sets    = true
ggml_metal_device_init: use shared buffers    = true
ggml_metal_device_init: recommendedMaxWorkingSetSize  = 30150.67 MB
| model                          |       size |     params | backend    | threads |  fa |            test |                  t/s |
| ------------------------------ | ---------: | ---------: | ---------- | ------: | --: | --------------: | -------------------: |
| gemma4 26B.A4B Q4_0            |  13.26 GiB |    25.23 B | MTL,BLAS   |       6 |   1 |           pp512 |      2999.32 ± 22.58 |
| gemma4 26B.A4B Q4_0            |  13.26 GiB |    25.23 B | MTL,BLAS   |       6 |   1 |           tg128 |        110.69 ± 0.24 |

build: 961e4b26a (9950)
Poslednja izmena:
Sorry na još jednom postu, istekao je edit... GPT-oss je takođe dosta brz. Q4, Q5 i Q8 kvantizacije su slične veličine. Nije vision model... Dao sam im svima (QWEN, Gemma, GPT-oss) isti prompt koji uključuje neke skorašnje informacije i fix za memory leak u MacOS 27 Dev Beta 3... Najbolje se snašao QWEN, dao je koncizan odgovor sa korenktnim izborom činjenica. Mada je pomešao generalne feature-e iz MacOS 27 sa novitetima koje donosi Beta 3
Nakon njega je GPT-oss, identifikovao je memory leak i neoficijelni fix, mada je halucinirao i izmislio da Apple planira da to popravi kroz zakrpu određene oznake, koje se odnosi na neki iOS patch.
Najlošiji je bio GEMMA model koji je pričao samo nešto generalno, bez previše detalja sa web-a...
Evo i benchmark-a GPT-oss modela u Q8 kvantizaciji 20b parametara
Kod:
ggml_metal_device_init: GPU name:   MTL0 (Apple M5 Max)
ggml_metal_device_init: GPU family: MTLGPUFamilyApple10  (1010)
ggml_metal_device_init: GPU family: MTLGPUFamilyCommon3 (3003)
ggml_metal_device_init: GPU family: MTLGPUFamilyMetal4  (5002)
ggml_metal_device_init: simdgroup reduction   = true
ggml_metal_device_init: simdgroup matrix mul. = true
ggml_metal_device_init: has unified memory    = true
ggml_metal_device_init: has bfloat            = true
ggml_metal_device_init: has tensor            = true
ggml_metal_device_init: use residency sets    = true
ggml_metal_device_init: use shared buffers    = true
ggml_metal_device_init: recommendedMaxWorkingSetSize  = 30150.67 MB
| model                          |       size |     params | backend    | threads |            test |                  t/s |
| ------------------------------ | ---------: | ---------: | ---------- | ------: | --------------: | -------------------: |
| gpt-oss 20B Q8_0               |  12.28 GiB |    20.91 B | MTL,BLAS   |       6 |           pp512 |      2867.67 ± 34.75 |
| gpt-oss 20B Q8_0               |  12.28 GiB |    20.91 B | MTL,BLAS   |       6 |           tg128 |        105.45 ± 0.11 |

build: 961e4b26a (9950)

Mali HoBiT
Čuven
- Učlanjen(a)
- 16.08.2002
- Poruke
- 2,049
- Poena
- 705
Moja oprema
- CPU & Cooler
- i7 14700kf P6.0/E4.6GHz Heatkiller IV waterblock
- Matična ploča
- Asus Z790 itx
- RAM
- G.Skill 2x24GB Patriot 8000MHz
- GPU
- Sapphire 6800XT EK waterblock
- Storage
- WD Black 850 1TB & Samsung 980Pro 2TB
- PSU
- Phanteks Revolt SFX 850w Platinum
- Kućište
- SSUPD Meshlicious, custom loop
- Monitor
- LG 38WN95C-W
- Miš & tastatura
- Keychron K7 max & Keychron m3 Metal
- Ostale periferije
- CP1500EPFCLCD
više inference nego trening na 3090. Hteo sam da pazarim još jednu 3090 pre par meseci, cena je bila oko 1k evra i bilo je par komada u oglasima, sad je pretpostavljam otišlo gore ako i ima karti u ponudi.
pmb
Slavan
- Učlanjen(a)
- 03.06.2016
- Poruke
- 944
- Poena
- 215
Moja oprema
- CPU & Cooler
- Ryzen 9 7950x + Arctic III 360
- Matična ploča
- MSI B650 MAG Tomahawk Wifi
- RAM
- 2x32GB Kingston DDR5 6000MHz
- GPU
- Gigabyte Aorus Master RTX 5090
- Storage
- 2TB KC3000 + 1TB KC3000, Crucial m.2 500, 2xHDD od po 4TB (WD RED i Blue)
- Zvuk
- Microlab Solo 6c, Audient ID14MKII
- PSU
- FSP Hydro PTM PRO 1350W Platinum ATX 3.1
- Kućište
- Lian Li Lancool 216 argb
- Monitor
- AOC 31.5" U32U3CV
- Miš & tastatura
- Logitech+ Redragon
- Ostale periferije
- LogiC270 Epson L386
- Laptop
- Lenovo
- Mobilni telefon
- Google Pixel 7a
- Pristup internetu
- Optički internet
Sledeće ne mora ni da izmisli - dok god je 24 GB VRAM-a ulaznica za ozbiljniji lokalni AI, 3090 će izgleda imati još života. Nekad kopa kripto, sad kopa tokene. 🙂

Mali HoBiT
Čuven
- Učlanjen(a)
- 16.08.2002
- Poruke
- 2,049
- Poena
- 705
Moja oprema
- CPU & Cooler
- i7 14700kf P6.0/E4.6GHz Heatkiller IV waterblock
- Matična ploča
- Asus Z790 itx
- RAM
- G.Skill 2x24GB Patriot 8000MHz
- GPU
- Sapphire 6800XT EK waterblock
- Storage
- WD Black 850 1TB & Samsung 980Pro 2TB
- PSU
- Phanteks Revolt SFX 850w Platinum
- Kućište
- SSUPD Meshlicious, custom loop
- Monitor
- LG 38WN95C-W
- Miš & tastatura
- Keychron K7 max & Keychron m3 Metal
- Ostale periferije
- CP1500EPFCLCD
ja bih izabrao jednu 3090 za AI razvoj ispred dgx-a...
Mali HoBiT
Čuven
- Učlanjen(a)
- 16.08.2002
- Poruke
- 2,049
- Poena
- 705
Moja oprema
- CPU & Cooler
- i7 14700kf P6.0/E4.6GHz Heatkiller IV waterblock
- Matična ploča
- Asus Z790 itx
- RAM
- G.Skill 2x24GB Patriot 8000MHz
- GPU
- Sapphire 6800XT EK waterblock
- Storage
- WD Black 850 1TB & Samsung 980Pro 2TB
- PSU
- Phanteks Revolt SFX 850w Platinum
- Kućište
- SSUPD Meshlicious, custom loop
- Monitor
- LG 38WN95C-W
- Miš & tastatura
- Keychron K7 max & Keychron m3 Metal
- Ostale periferije
- CP1500EPFCLCD
ne možeš da zanemariš cenu ali i pored cene, output na 3090 je 4x(vllm) veći, lagano služi više korisnika u isto vreme, finetuning... kompletan AI razvojni ciklus može da se pokrije sa manjim modelima. Memory capacity vs bandwidth problem na koji naiđeš kada shvatiš da ti treba 3 ili više lokalnih modela za kompletan AI sistem - llm/vlm, embedder, reranker, image generation, tts... Sve ih spakuješ lagano na dgx, ima kapacitet ali ne bandwidth i compute da te usreće kao korisnika.
Da, ali ipak za to je namenjena neka multi GPU kombinacija. 3090 je stara arhitektura bez HW podrške za FP8 i FP4 koju ima Blackwell arthitektura, a koju nVidia gura za LLM. 128GB VRAM-a omogućava da radiš na većim kvantizacijama, koje se kasnije skaliraju na nižim (ne obrnuto). Svakako je prednost 3090, x86 razvojno okruženje. DGX Spark je za sada samo Linux, a i ako bude Windows, biće ARM verzija, logično. Potrošnja takođe nije zanemarljiva za 3090 sistem.
Generalno za LLM jeste mnogo bitniji bandwidth, dok za VLM je puno važniji kapacitet samog VRAM-a, zbog razloga koje si naveo.
Ipak, svako mozganje tog tipa kvari cenovna matematika, kada jedan 5090 košta 10k eur, teško je biti pametan.
Generalno za LLM jeste mnogo bitniji bandwidth, dok za VLM je puno važniji kapacitet samog VRAM-a, zbog razloga koje si naveo.
Ipak, svako mozganje tog tipa kvari cenovna matematika, kada jedan 5090 košta 10k eur, teško je biti pametan.
Mali HoBiT
Čuven
- Učlanjen(a)
- 16.08.2002
- Poruke
- 2,049
- Poena
- 705
Moja oprema
- CPU & Cooler
- i7 14700kf P6.0/E4.6GHz Heatkiller IV waterblock
- Matična ploča
- Asus Z790 itx
- RAM
- G.Skill 2x24GB Patriot 8000MHz
- GPU
- Sapphire 6800XT EK waterblock
- Storage
- WD Black 850 1TB & Samsung 980Pro 2TB
- PSU
- Phanteks Revolt SFX 850w Platinum
- Kućište
- SSUPD Meshlicious, custom loop
- Monitor
- LG 38WN95C-W
- Miš & tastatura
- Keychron K7 max & Keychron m3 Metal
- Ostale periferije
- CP1500EPFCLCD
Sve je kompromis danas, optimizuješ na osnovu sistema koji gradiš. U mojoj mašini sa 2x3090, svi "veći" modeli koje koristim su FP8(+Marlin kernel) ili BF16, Ampere arhitektura ima odličnu podršku za sve AI, ne bih je nazvao starom već zdrelom 😁. Imam i mašinu sa 5090 - nisam srećan sa performansama, možda 5 do 20% brža od dual 3090 u zavisnosti od aplikacije a pritom 5090 ne može da potera Qwen3.6-27B ili 35B FP8.
Moj home AI sistem ima 3 noda:
1x3090 - host za 4B embedder I 4B reranker modele
2x3090 - 35B moe, classifier/helper
1x5090 - Image gen i tts
Moj home AI sistem ima 3 noda:
1x3090 - host za 4B embedder I 4B reranker modele
2x3090 - 35B moe, classifier/helper
1x5090 - Image gen i tts
To je drugačija slika od "odabrao bih 3090" 🙂
2x 3090 je ipak 48GB VRAM-a što je super. Ja imam dve Mac Studio mašine, ali sam ovog puta odlučio za CUDA. MLX je dobar AKO je sve optimizovano. Sami modeli i nisu možda toliki problem, ali ima još uvek dosta nodova koji ne rade na Mac-u. LLM je uglavnom OK. Čak i tada Spark u LM Studio-u gura 70-80 tk/s na većini LLM-ova, što sa Mac-om nije baš jednostavno postići.
Razmišljao sam i o nVidia grafičkim karticama, ali nisam hteo da se zezam sa Windows custom mašinom zbog toga.
Poslednja izmena:

lognebudo
Zapažen
- Učlanjen(a)
- 14.10.2026
- Poruke
- 1
- Poena
- 2
Pošto se ovde dosta pričalo o VRAM-u i o kompresiji KV keša, jedna stvar koju sam izmerio a koja ne zavisi od kartice: koliko kešа zapravo iskoristite po poruci.
Lokalni model (Ollama, llama.cpp) ponovo koristi keš prompta samo dok se prompt poklapa od prvog tokena. Ako vaš alat stavlja datum i vreme na vrh system prompta, svaka poruka se u celini računa iznova. Ja sam to izmerio na promptu od 324 tokena, na svom demonu:
Iste reči, 3,5 puta brži prefill. Na dužim promptovima (RAG, alati, istorija) razlika je veća, i to je ono što osetite kao pauzu pre prvog tokena.
Možete proveriti sami, dva puta isti zahtev:
Promenite minut u datumu i pošaljite opet:
radi uz Ollama, ništa ne ide van mašine). Ima stranicu na koju usmerite VS Code Copilot, Open WebUI ili skriptu umesto na Ollama, pa vidite za svaku poruku koliko je tokena došlo
iz keša i na kom mestu u promptu je keš pukao. Interfejs postoji i na srpskom, latinica i ćirilica. Ako neko proba na 3090 ili na Macu, zanimaju me brojke.


Lokalni model (Ollama, llama.cpp) ponovo koristi keš prompta samo dok se prompt poklapa od prvog tokena. Ako vaš alat stavlja datum i vreme na vrh system prompta, svaka poruka se u celini računa iznova. Ja sam to izmerio na promptu od 324 tokena, na svom demonu:
- vremenska oznaka napred: 4 tokena iz keša, prefill 64,6 ms
- ista oznaka na kraju prompta: 290 tokena iz keša, prefill 18,6 ms
Iste reči, 3,5 puta brži prefill. Na dužim promptovima (RAG, alati, istorija) razlika je veća, i to je ono što osetite kao pauzu pre prvog tokena.
Možete proveriti sami, dva puta isti zahtev:
Kod:
curl -s localhost:11434/api/chat -d '{"model":"qwen3.5:9b","stream":false,"messages":[{"role":"system","content":"Datum: 2026-10-14 10:00. Ti si asistent."},{"role":"user","content":"Zdravo"}]}' | grep -o '"prompt_eval_cached_count":[0-9]*'prompt_eval_cached_count padne na nulu. Stavite datum na kraj system prompta i ponovite: ostaje skoro ceo. Ovo sam uhvatio praveći alat za posmatranje lokalnih modela, LLMxRay https://github.com/LogneBudo/llmxray,npx llmxray, radi uz Ollama, ništa ne ide van mašine). Ima stranicu na koju usmerite VS Code Copilot, Open WebUI ili skriptu umesto na Ollama, pa vidite za svaku poruku koliko je tokena došlo
iz keša i na kom mestu u promptu je keš pukao. Interfejs postoji i na srpskom, latinica i ćirilica. Ako neko proba na 3090 ili na Macu, zanimaju me brojke.
Zanimljiv post. Jedno od rešenja je alat na serveru koji bi model pozvao da proveri datum, ali je tu pitanje kako model barata alatima posebno slabija kvantizacija.
Drugo rešenje bi bilo da se datum ne ubacuje u početak prompta tj. da ne bude u početnom prefiksu kako llama.cpp ne bi videla to kao novi prompt i odlučila da ne koristi iz KV keša.
Drugo rešenje bi bilo da se datum ne ubacuje u početak prompta tj. da ne bude u početnom prefiksu kako llama.cpp ne bi videla to kao novi prompt i odlučila da ne koristi iz KV keša.
brzina mi nije bitna samo da može da učita Qwen 72B i da mu ostane lufta, malo mi fali da "povučem obarač"...na ebayu su 4000e minimum, nije mi jasno ovo "no import charges" kako oni mogu da odluče da li će kod nas naplatiti carinu ili ne ili oni refundiraju carinu ako se naplati
testthenext
Čuven
- Učlanjen(a)
- 02.05.2004
- Poruke
- 956
- Poena
- 645
Moja oprema
- Pristup internetu
- Optički internet
Meni pise drugacije:
Dakle, uzimaju 641€ za troskove uvoza. Posle vrate sta preostane, ako preostane!
Details zu Versand und Gebühren
| Preis | 2.938,51 EUR | |
| AmazonGlobal-Versand | 85,07 EUR | |
| Geschätzte Importkosten | 641,01 EUR | |
| Summe | 3.664,58 EUR |
Dakle, uzimaju 641€ za troskove uvoza. Posle vrate sta preostane, ako preostane!
meni piše ovo za Montenegro, možda ne mogu da nas nađu 😀
| Price | EUR 2,938.51 | |
| AmazonGlobal Shipping | EUR 57.20 | |
| Estimated Import Charges | EUR 0.00 | |
| Total | EUR 2,995.71 |
brzina mi nije bitna samo da može da učita Qwen 72B i da mu ostane lufta, malo mi fali da "povučem obarač"...na ebayu su 4000e minimum, nije mi jasno ovo "no import charges" kako oni mogu da odluče da li će kod nas naplatiti carinu ili ne ili oni refundiraju carinu ako se naplati
Ne treba ti QWEN 72b 2.5 iz 2024. godine...
QWEN 3.8 27b će bolje raditi.
Imaj isto u vidu da kod AMD/Windows mašine memorije nije deljena kao kod Mac,-a već moraš unapred da definišeš koliko je od tih 128GB VRAM (max. 96GB), a šta ostaje kao RAM.
To znači da QWEN 72b neće biti baš komforan u max. 96GB, ako ide veća kvantizacija, jer puno pojedu prompt, alati itd... Još jedan razlog za QWEN 3.8 koji je oko 30GB.
Instalacija aplikacije
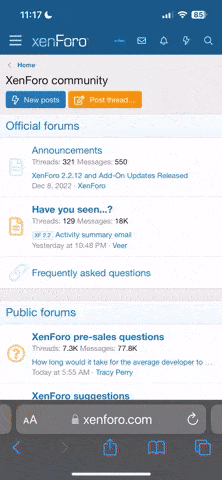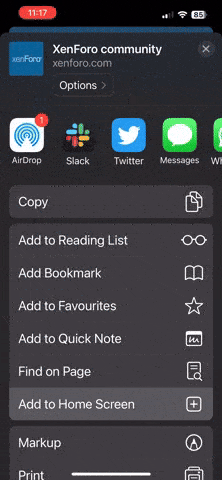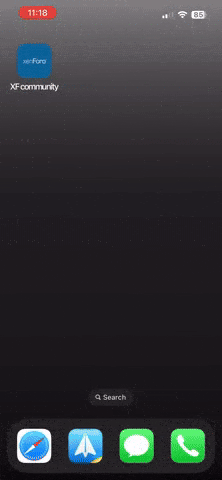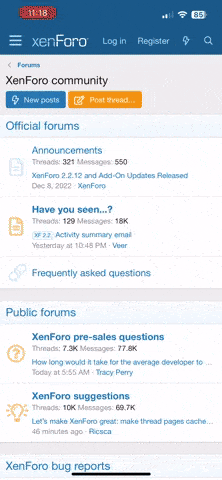
How to install the app on iOS
Follow along with the video below to see how to install our site as a web app on your home screen.
Napomena: this_feature_currently_requires_accessing_site_using_safari