Koristite zastareli preglednik. Možda se neće pravilno prikazivati ova ili druge veb stranice.
Trebalo bi da nadogradite ili koristite alternativni preglednik.
Trebalo bi da nadogradite ili koristite alternativni preglednik.
Lokalno korišćenje AI modela
- Začetnik teme Space Beer
- Datum pokretanja
GEMMA je ipak puno brži LLM od QWEN... Trebalo bi da je i bolje optimizovana za agentic rad, tako da ko eksperimentiše sa Openclaw, trebalo da je puno bolji izbor od QWEN-a. Ipak, imati u vidu da za neke generalne upotrebe nije baš dobra kao QWEN, jer prompt barata sa 4b od 26b parametara. Iako je preko MCP-a povezana na web search, ipak vadi odgovore iz svog "znanja" i to nije baš najsvežije. Čak i eksplicitan prompt da koristi search i rezultate od zadnjih 7 dana ne pomaže previše.
Kod:
ggml_metal_device_init: GPU name:   MTL0 (Apple M5 Max)
ggml_metal_device_init: GPU family: MTLGPUFamilyApple10  (1010)
ggml_metal_device_init: GPU family: MTLGPUFamilyCommon3 (3003)
ggml_metal_device_init: GPU family: MTLGPUFamilyMetal4  (5002)
ggml_metal_device_init: simdgroup reduction   = true
ggml_metal_device_init: simdgroup matrix mul. = true
ggml_metal_device_init: has unified memory    = true
ggml_metal_device_init: has bfloat            = true
ggml_metal_device_init: has tensor            = true
ggml_metal_device_init: use residency sets    = true
ggml_metal_device_init: use shared buffers    = true
ggml_metal_device_init: recommendedMaxWorkingSetSize  = 30150.67 MB
| model                          |       size |     params | backend    | threads |  fa |            test |                  t/s |
| ------------------------------ | ---------: | ---------: | ---------- | ------: | --: | --------------: | -------------------: |
| gemma4 26B.A4B Q4_0            |  13.26 GiB |    25.23 B | MTL,BLAS   |       6 |   1 |           pp512 |      2999.32 ± 22.58 |
| gemma4 26B.A4B Q4_0            |  13.26 GiB |    25.23 B | MTL,BLAS   |       6 |   1 |           tg128 |        110.69 ± 0.24 |

build: 961e4b26a (9950)
Poslednja izmena:
Sorry na još jednom postu, istekao je edit... GPT-oss je takođe dosta brz. Q4, Q5 i Q8 kvantizacije su slične veličine. Nije vision model... Dao sam im svima (QWEN, Gemma, GPT-oss) isti prompt koji uključuje neke skorašnje informacije i fix za memory leak u MacOS 27 Dev Beta 3... Najbolje se snašao QWEN, dao je koncizan odgovor sa korenktnim izborom činjenica. Mada je pomešao generalne feature-e iz MacOS 27 sa novitetima koje donosi Beta 3
Nakon njega je GPT-oss, identifikovao je memory leak i neoficijelni fix, mada je halucinirao i izmislio da Apple planira da to popravi kroz zakrpu određene oznake, koje se odnosi na neki iOS patch.
Najlošiji je bio GEMMA model koji je pričao samo nešto generalno, bez previše detalja sa web-a...
Evo i benchmark-a GPT-oss modela u Q8 kvantizaciji 20b parametara
Nakon njega je GPT-oss, identifikovao je memory leak i neoficijelni fix, mada je halucinirao i izmislio da Apple planira da to popravi kroz zakrpu određene oznake, koje se odnosi na neki iOS patch.
Najlošiji je bio GEMMA model koji je pričao samo nešto generalno, bez previše detalja sa web-a...
Evo i benchmark-a GPT-oss modela u Q8 kvantizaciji 20b parametara
Kod:
ggml_metal_device_init: GPU name:   MTL0 (Apple M5 Max)
ggml_metal_device_init: GPU family: MTLGPUFamilyApple10  (1010)
ggml_metal_device_init: GPU family: MTLGPUFamilyCommon3 (3003)
ggml_metal_device_init: GPU family: MTLGPUFamilyMetal4  (5002)
ggml_metal_device_init: simdgroup reduction   = true
ggml_metal_device_init: simdgroup matrix mul. = true
ggml_metal_device_init: has unified memory    = true
ggml_metal_device_init: has bfloat            = true
ggml_metal_device_init: has tensor            = true
ggml_metal_device_init: use residency sets    = true
ggml_metal_device_init: use shared buffers    = true
ggml_metal_device_init: recommendedMaxWorkingSetSize  = 30150.67 MB
| model                          |       size |     params | backend    | threads |            test |                  t/s |
| ------------------------------ | ---------: | ---------: | ---------- | ------: | --------------: | -------------------: |
| gpt-oss 20B Q8_0               |  12.28 GiB |    20.91 B | MTL,BLAS   |       6 |           pp512 |      2867.67 ± 34.75 |
| gpt-oss 20B Q8_0               |  12.28 GiB |    20.91 B | MTL,BLAS   |       6 |           tg128 |        105.45 ± 0.11 |

build: 961e4b26a (9950)

Mali HoBiT
Čuven
- Učlanjen(a)
- 16.08.2002
- Poruke
- 2,046
- Poena
- 705
Moja oprema
- CPU & Cooler
- i7 14700kf P6.0/E4.6GHz Heatkiller IV waterblock
- Matična ploča
- Asus Z790 itx
- RAM
- G.Skill 2x24GB Patriot 8000MHz
- GPU
- Sapphire 6800XT EK waterblock
- Storage
- WD Black 850 1TB & Samsung 980Pro 2TB
- PSU
- Phanteks Revolt SFX 850w Platinum
- Kućište
- SSUPD Meshlicious, custom loop
- Monitor
- LG 38WN95C-W
- Miš & tastatura
- Keychron K7 max & Keychron m3 Metal
- Ostale periferije
- CP1500EPFCLCD
više inference nego trening na 3090. Hteo sam da pazarim još jednu 3090 pre par meseci, cena je bila oko 1k evra i bilo je par komada u oglasima, sad je pretpostavljam otišlo gore ako i ima karti u ponudi.
Instalacija aplikacije
How to install the app on iOS
Follow along with the video below to see how to install our site as a web app on your home screen.
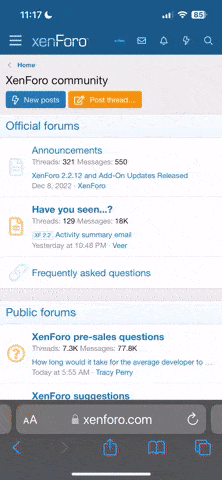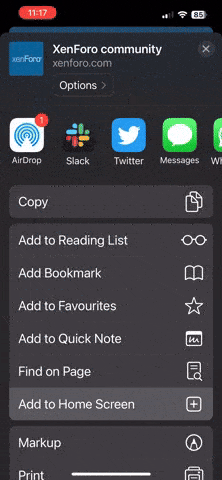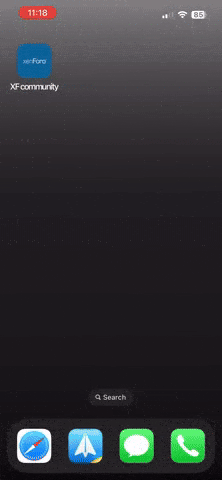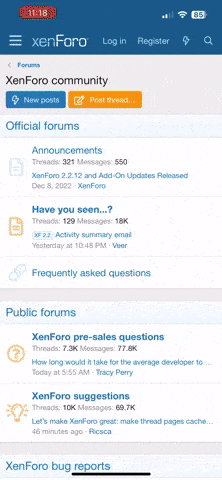
Napomena: this_feature_currently_requires_accessing_site_using_safari